En résumé
Le Laboratoire est l'espace d'analyse d'un projet. Il part d'un jeu de données en format large — une ligne par séjour, une colonne par variable — sur lequel on branche des analyses configurables sans écrire de code (tableau descriptif, régression), et un IDE R et Python pour tout ce qui demande du sur-mesure.
Cette page prolonge le parcours de l'entrepôt de données : l'entrepôt sert à explorer et à sélectionner, le Laboratoire à analyser. Les données restent celles de la MIMIC-IV Demo.
Jeux de données
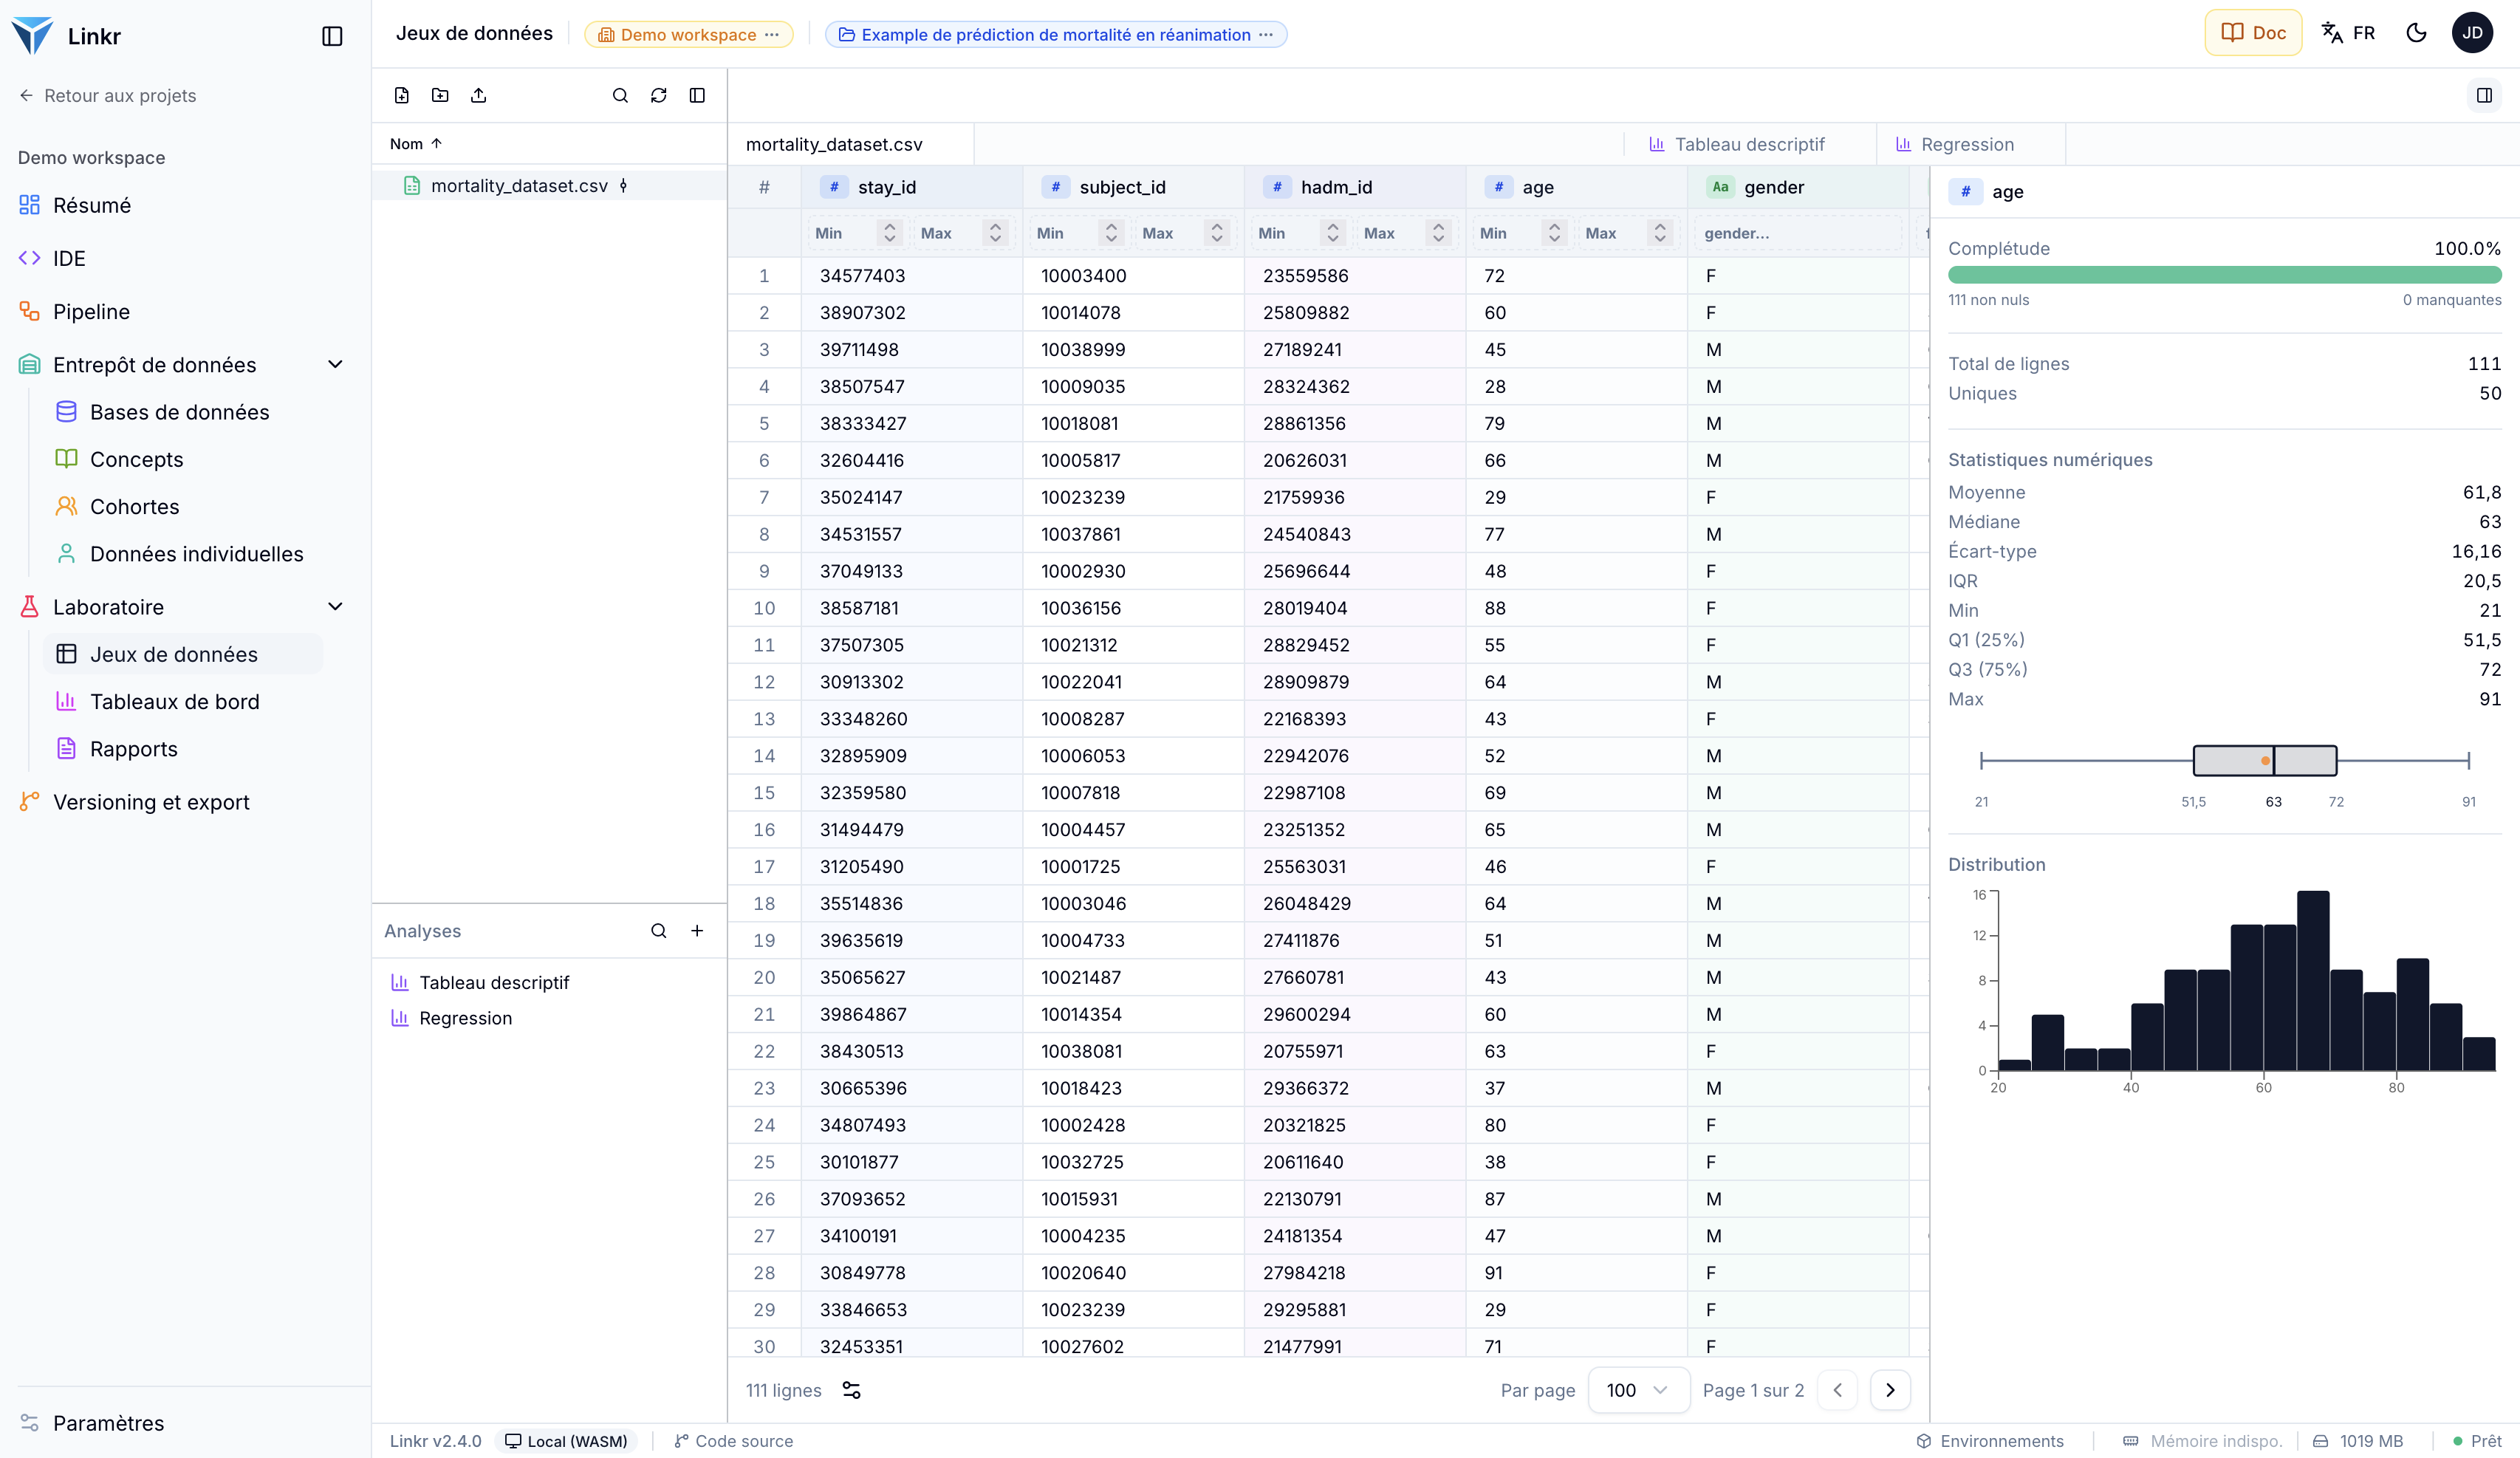
Un jeu de données (ou dataset) est un tableau en format large : une ligne par séjour, une colonne par variable. C'est le format attendu par la quasi-totalité des outils statistiques — et l'inverse du format long de l'entrepôt, où chaque mesure occupe sa propre ligne. L'article Organiser ses données détaille les deux formes et le passage de l'une à l'autre.
Le jeu de données de la démo compte 111 séjours et 21 variables : âge, sexe,
unité d'admission, durée de séjour, puis les extrema biologiques des premières 24 heures
(lactate, créatinine, bicarbonates, score de Glasgow…) et la variable à prédire,
in_hospital_death.
En sélectionnant une colonne, le panneau de droite affiche sa complétude, ses statistiques et sa distribution — moyenne, médiane, quartiles, boîte à moustaches et histogramme. C'est la première chose à regarder avant toute analyse : une variable à 39 % de valeurs manquantes ne se traite pas comme une variable complète.
Analyses
Sous la liste des fichiers, le volet Analyses regroupe les analyses attachées au jeu de données. Celui de la démo en contient deux : un Tableau descriptif et une Regression. Chacune est un formulaire à gauche, un résultat à droite.
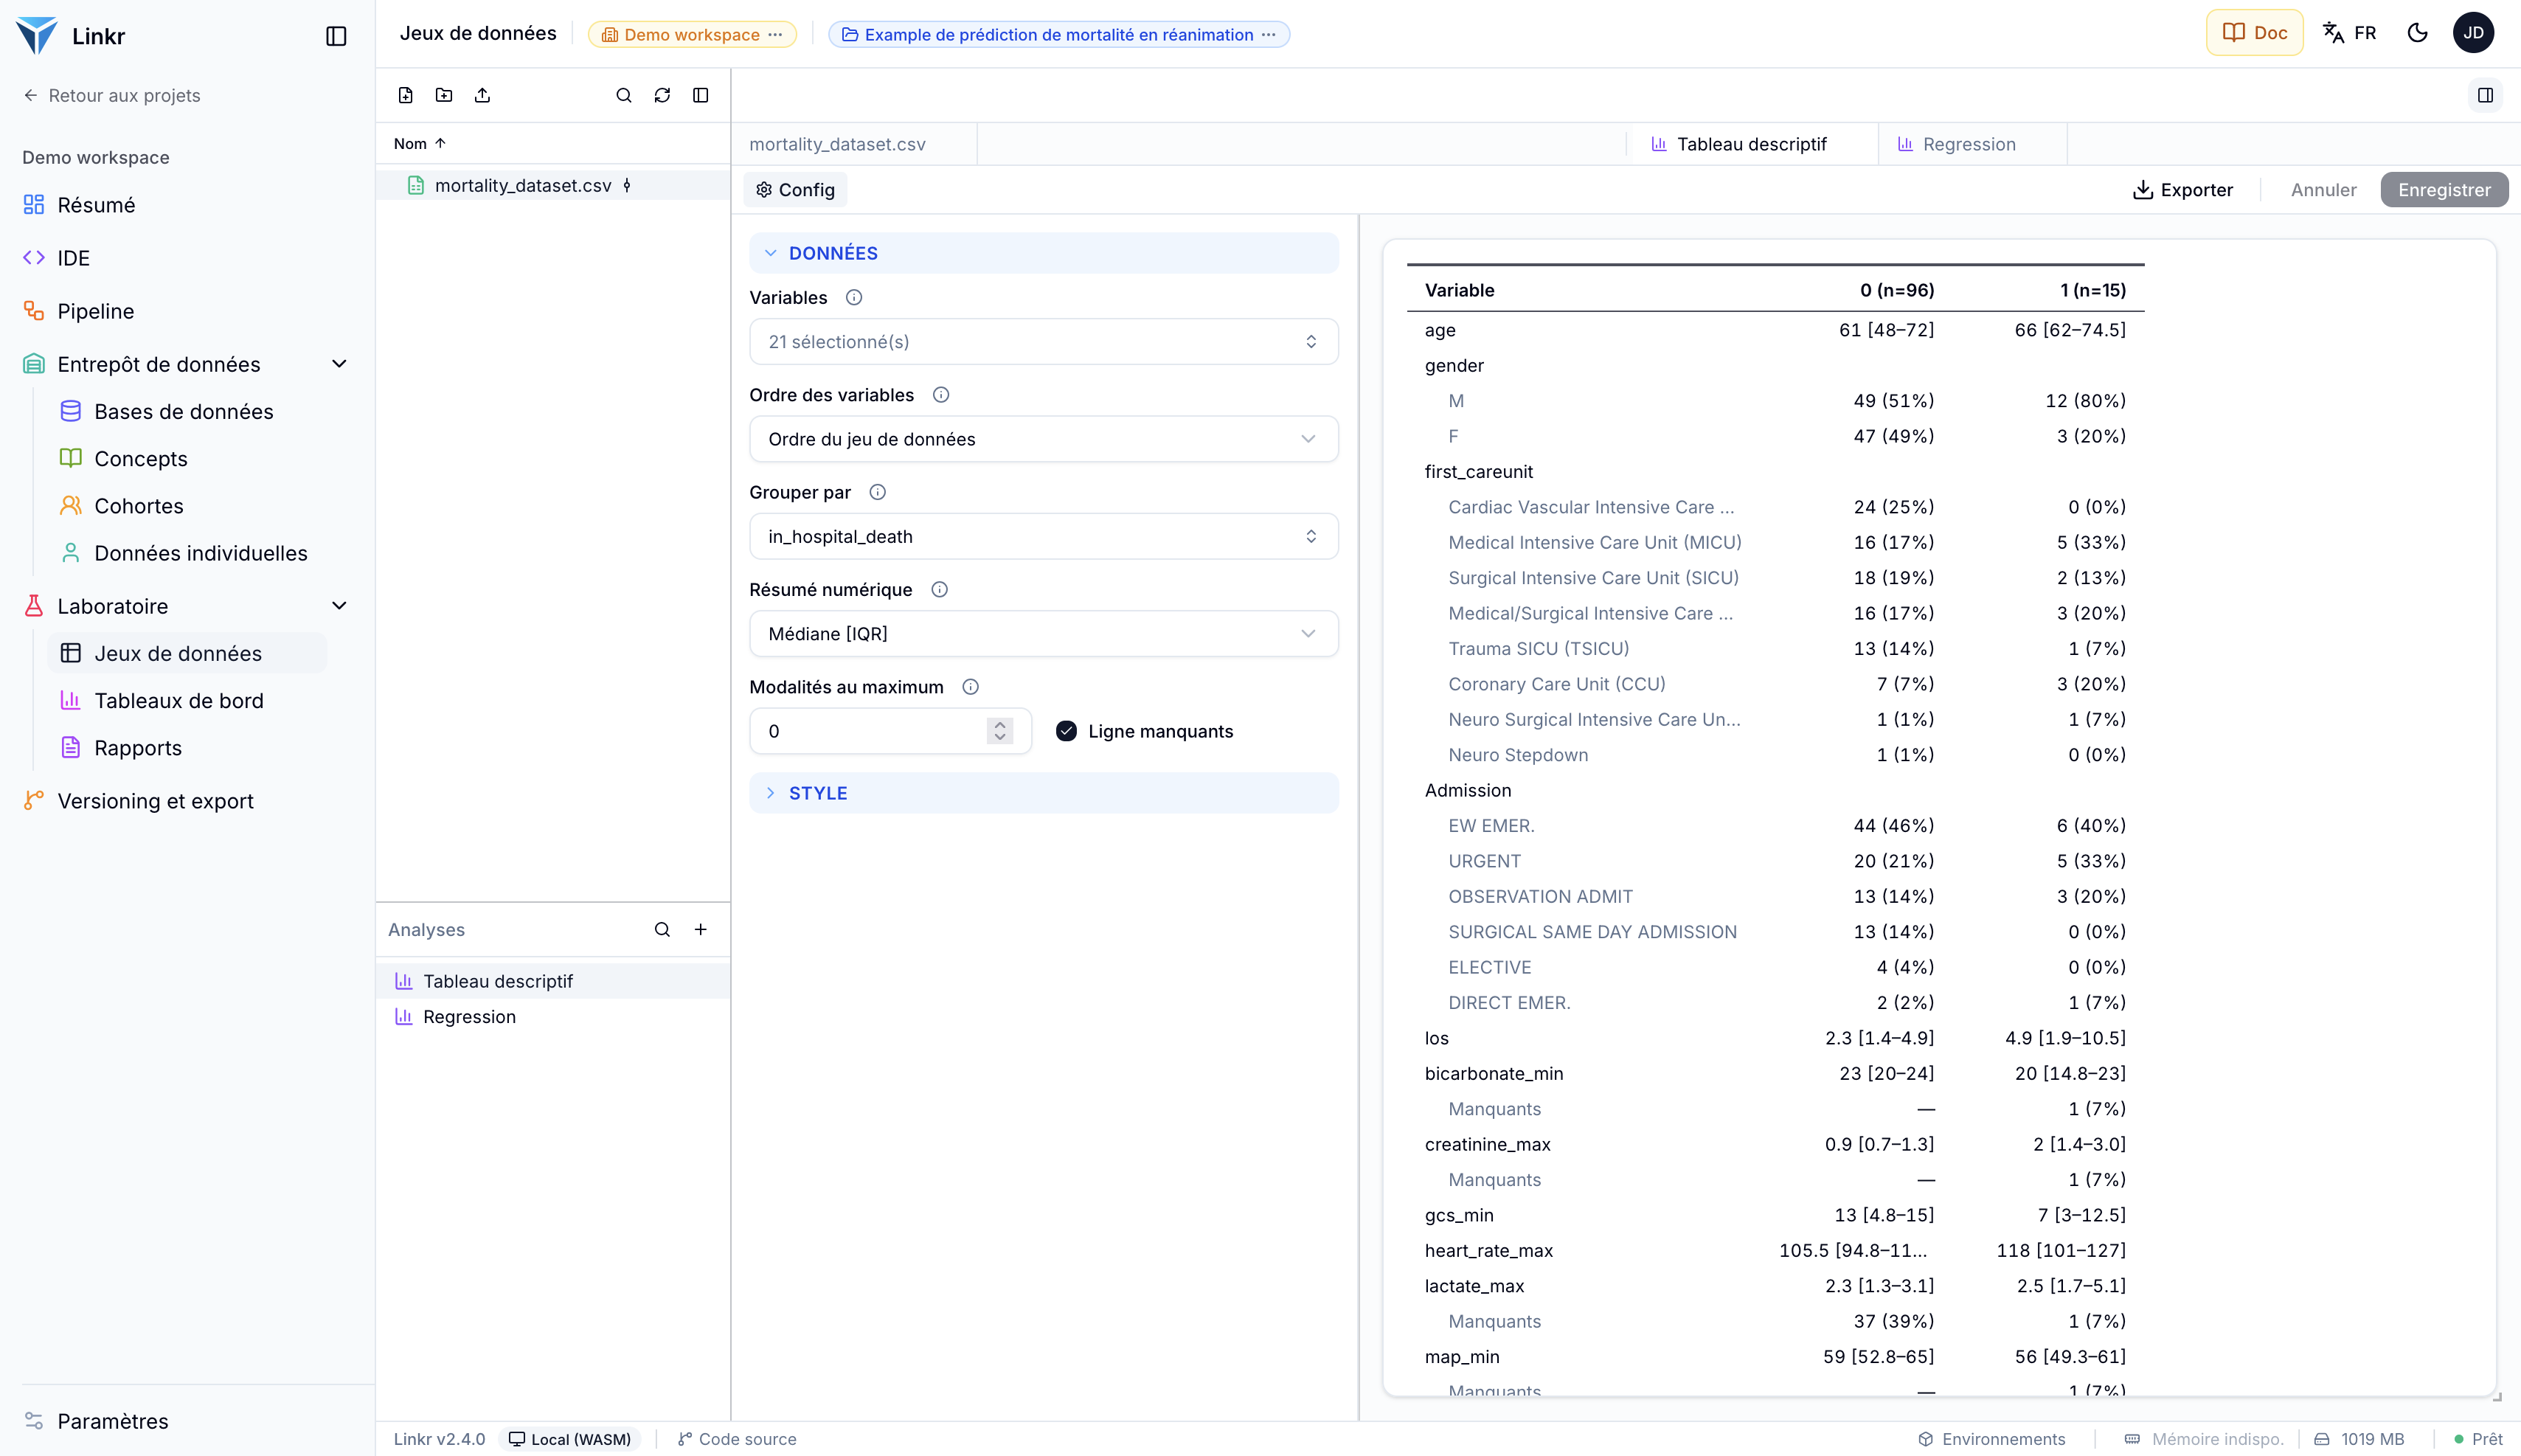
Le tableau descriptif — la Table 1 de tout article clinique — se configure en quelques champs : les variables à inclure, la variable de groupement, et le résumé numérique (ici médiane [IQR]). Les variables numériques sont résumées par leur médiane et leur intervalle interquartile, les catégorielles par leur effectif et leur pourcentage, et les valeurs manquantes apparaissent sur leur propre ligne quand Ligne manquants est coché.
On lit directement le contraste entre les deux groupes : les patients décédés sont plus âgés (66 ans contre 61), restent plus longtemps (4,9 jours contre 2,3) et ont un lactate et une créatinine plus élevés. Le bouton Exporter sort le tableau prêt à être publié.
IDE
Tout ne se fait pas au formulaire. L'IDE intégré ouvre les scripts du projet — R Markdown, notebooks Jupyter, SQL, Python, R — et les exécute dans le navigateur, sans rien installer.
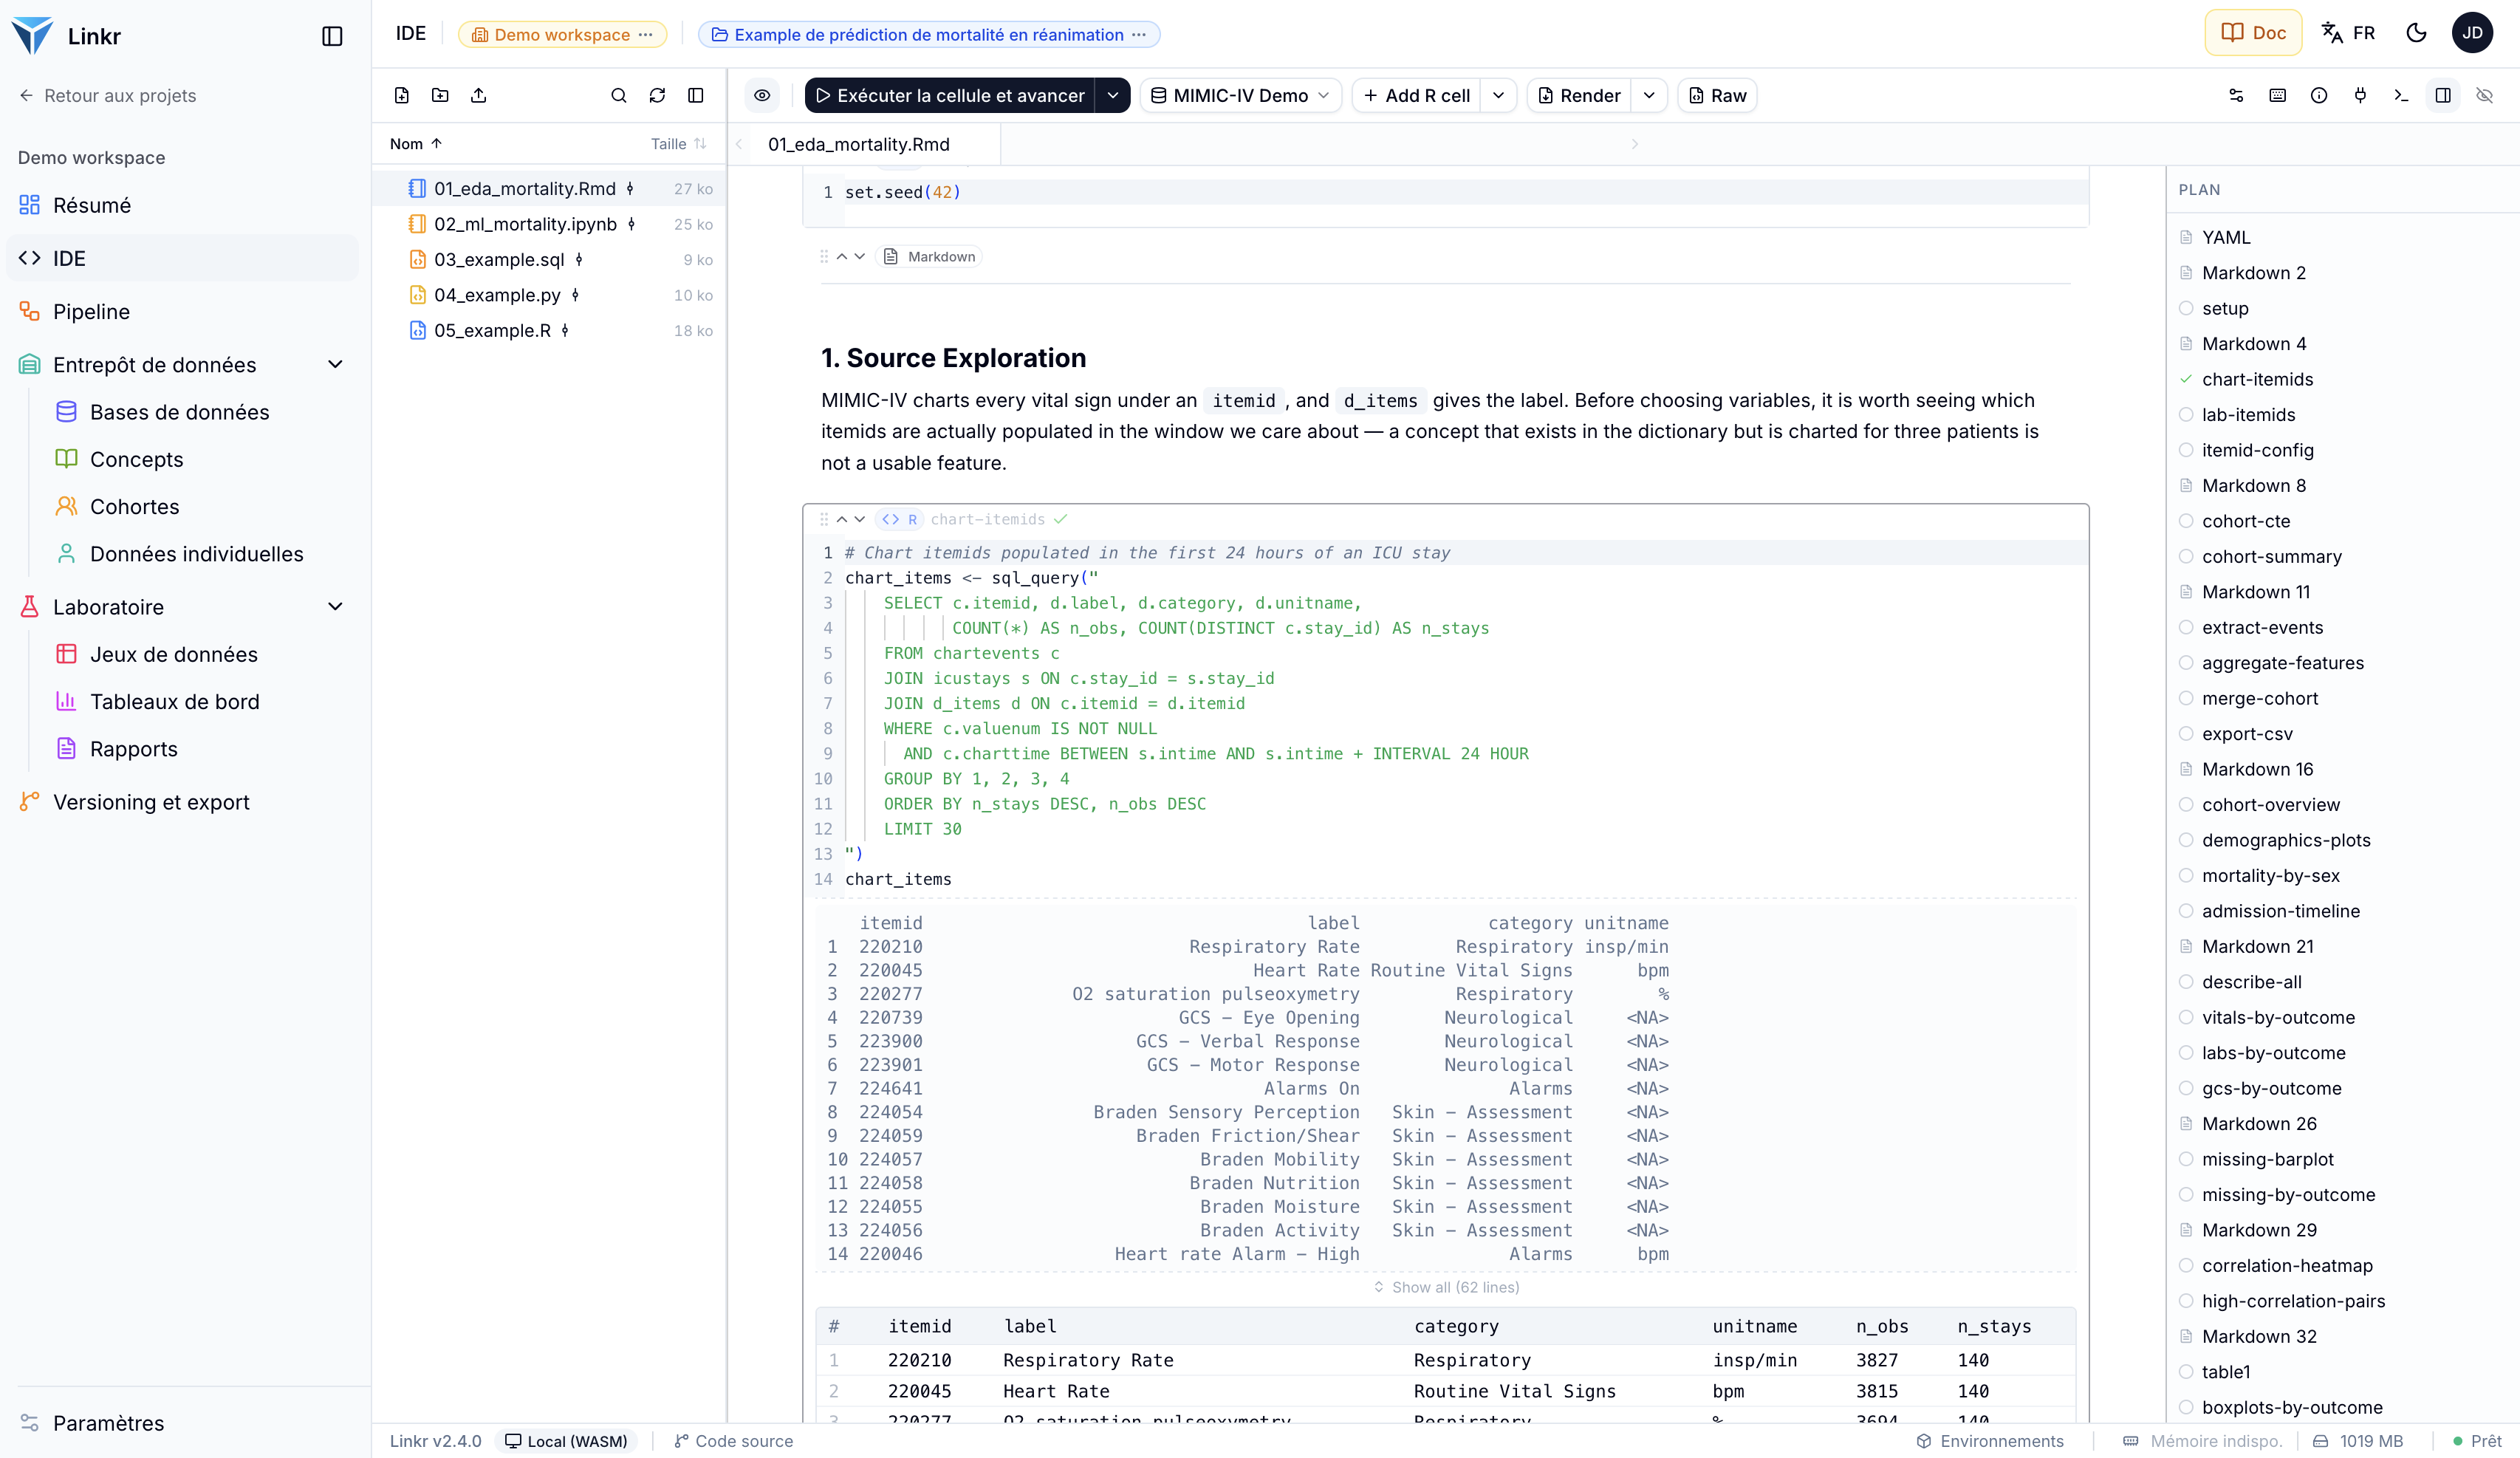
Le projet fournit cinq scripts, dont l'analyse exploratoire en R Markdown ci-dessus et un notebook de modélisation en Python. Les cellules s'exécutent une par une (Run cell and advance), alternent texte, code et résultats, et le plan de droite permet de naviguer dans un document long.
Le point important : la liste déroulante en haut désigne la base interrogée — ici MIMIC-IV Demo. Une cellule SQL attaque donc directement l'entrepôt, et son résultat revient sous forme de tableau réutilisable dans le code R qui suit. C'est ce chaînage qui produit le jeu de données du début de cette page.
Pour aller plus loin
- Explorer un entrepôt de données de santé — d'où viennent les données analysées ici.
- Format long et format large — pourquoi l'entrepôt et le Laboratoire n'utilisent pas la même forme de tableau.
- Modes de déploiement — ce qui tourne dans le navigateur et ce qui demande un serveur.