En résumé
R est un langage conçu pour les statistiques et l’analyse de données. Une fois les données extraites en SQL, R sert à les nettoyer, calculer des indicateurs et produire des graphiques et tableaux de qualité publication. Il est très répandu en biostatistique et en recherche clinique. On l’utilise généralement dans un environnement de travail dédié comme Positron ou RStudio, avec un ensemble de librairies appelé le tidyverse.
Cet article suppose que vous avez parcouru Pourquoi apprendre à coder ? et l’introduction au SQL. SQL sort les données de la base ; R prend ensuite le relais pour les analyser.
Pourquoi R en recherche clinique
R a été créé au début des années 1990 par deux statisticiens de l’université d’Auckland, Ross Ihaka et Robert Gentleman (FAQ officielle de R), pour le calcul statistique et les graphiques. C’est ce qui explique sa popularité en santé :
- Les méthodes statistiques (tests, régressions, modèles de survie…) y sont disponibles nativement ou via des librairies éprouvées.
- Les graphiques produits sont d’excellente qualité.
- C’est souvent le langage enseigné en médecine et en santé publique, donc celui de vos futurs collègues et encadrants.
L’environnement de travail
Pour écrire et exécuter du R, on passe généralement par un environnement de travail dédié, qui rassemble dans une même fenêtre l’éditeur de code, la console qui exécute les commandes, les graphiques et l’aide.
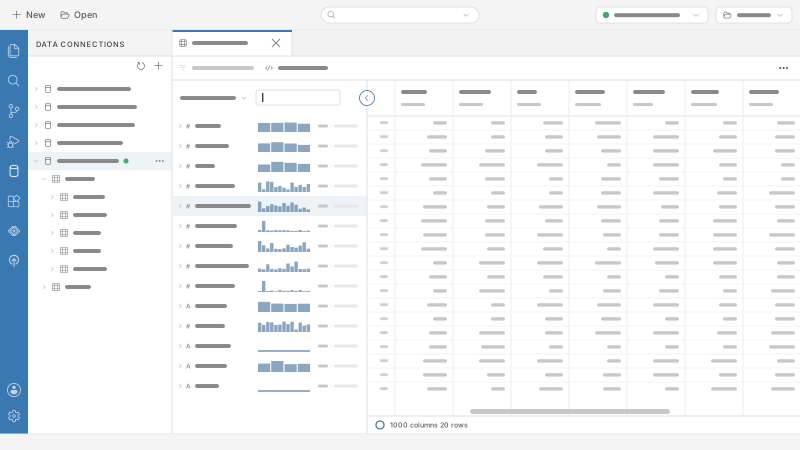
- Positron, développé par Posit (l’éditeur de RStudio), est celui que nous recommandons. Gratuit, il gère R et Python et offre des outils pensés pour l’analyse de données : un panneau qui liste les variables en mémoire, un explorateur de données pour parcourir, trier et filtrer un tableau comme dans un tableur, et un historique des graphiques.
- RStudio, son prédécesseur, reste très répandu et s’utilise de la même façon.
- VS Code est un éditeur généraliste très polyvalent : on peut y écrire du R, du Python, du SQL et bien d’autres langages. Pour R, il demande en revanche d’installer et de configurer une extension, et offre moins de confort pour explorer ses données.
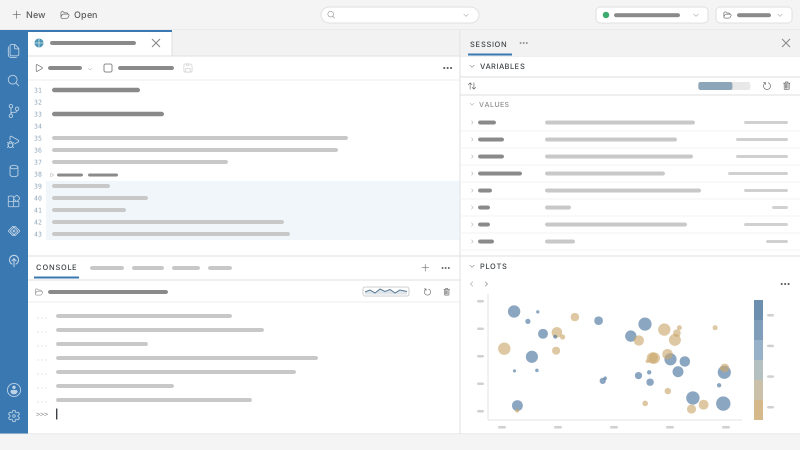
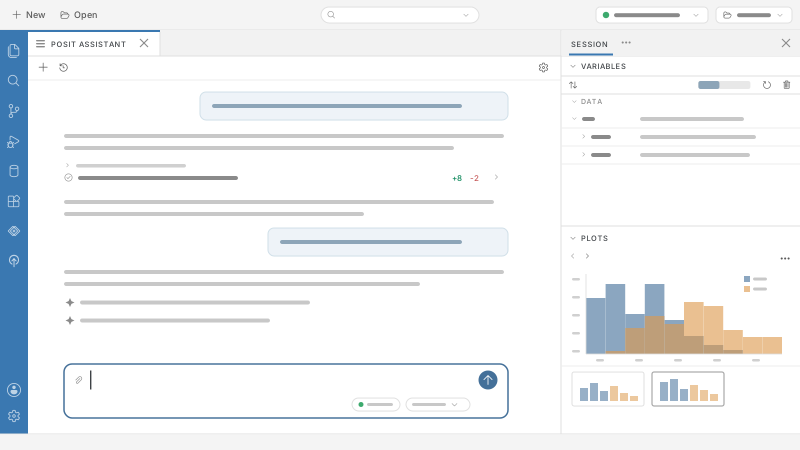
Le code s'écrit dans l'éditeur et s'exécute dans la console ; à droite, le panneau Variables liste les objets en mémoire et le panneau Graphiques affiche les figures produites.
Le tidyverse : manipuler les données
Le tidyverse est un ensemble de librairies conçues pour fonctionner ensemble, avec la même logique et la même syntaxe. À lui seul, il permet de faire la grande majorité de ce dont on a besoin pour manipuler des données de recherche en santé :
dplyrpour manipuler les données : filtrer, sélectionner, regrouper, résumer (c’est l’objet de cette section) ;ggplot2pour créer des graphiques (section suivante) ;tidyrpour remettre un tableau en forme, par exemple passer du format long au format large ;readrpour importer des fichiers, comme les fichiers CSV ;stringr,lubridateetforcatspour travailler sur le texte, les dates et les variables catégorielles ;tibbleetpurrrpour des tableaux plus lisibles et pour répéter une même opération.
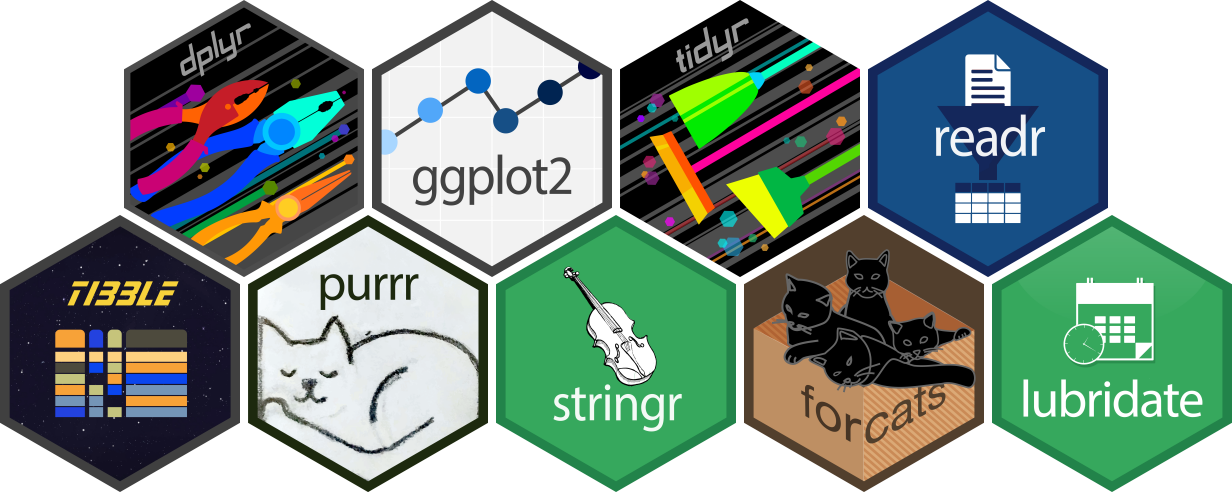
Une seule ligne, library(tidyverse), les charge tous.
Une librairie, c'est quoi ?
Une librairie (ou package) est un ensemble de fonctions prêtes à l’emploi, écrites par d’autres, qu’on ajoute à R pour étendre ses capacités. On les installe une fois avec install.packages(“nom”), puis on les charge dans chaque script avec library(nom).
dplyr fournit un petit vocabulaire de verbes qui reprennent les briques d’une requête SQL : filter() filtre les lignes (comme WHERE), select() choisit les colonnes (comme SELECT), group_by() + summarise() agrègent (comme GROUP BY). On les enchaîne avec le pipe |>, qui se lit « ensuite » : prends les données, ensuite filtre, ensuite regroupe…
library(dplyr)

# On part d'un tableau `patients` qui contient les colonnes sexe, age et creatinine
patients |>
filter(sexe == "F", age > 65) |>      # on filtre les femmes de plus de 65 ans
group_by(sexe) |>                     # on regroupe par sexe
summarise(
  n = n(),                            # on calcule le nombre de patientes
  creat_moy = mean(creatinine, na.rm = TRUE)  # et la créatinine moyenne
)| sexe | n | creat_moy |
|---|---|---|
| F | 3 | 155.3 |
Si vous avez lu l’article SQL, vous reconnaissez la logique : c’est le même raisonnement — filtrer, regrouper, résumer — dans une syntaxe différente.
Avant toute analyse, on regarde à quoi ressemblent les données. Quelques fonctions reviennent systématiquement :
head(patients)      # on affiche les premières lignes
summary(patients)   # on résume chaque colonne : min, max, moyenne, valeurs manquantes
nrow(patients)      # on compte les lignes
Ces trois commandes donnent déjà une bonne intuition de la structure et de la qualité d’un jeu de données.
Visualiser avec ggplot2
ggplot2 construit un graphique par couches : on déclare les données, ce qu’on met en abscisse et en ordonnée, puis le type de tracé.
library(ggplot2)

ggplot(patients, aes(x = age, y = creatinine)) +  # on crée un graphique avec l'âge en x et la créatinine en y
geom_point(color = "#2563eb", size = 3) +       # on ajoute un nuage de points
geom_smooth(method = "lm", color = "#2563eb",   # et une droite de tendance linéaire,
            fill = "#2563eb", alpha = 0.15) +   # avec son intervalle de confiance
labs(                                           # on ajoute le titre et le nom des axes
  title = "Créatinine selon l'âge",
  x = "Âge (années)",
  y = "Créatinine (µmol/L)"
) +
theme_minimal(base_size = 14) +                 # on choisit un thème épuré
theme(plot.title = element_text(hjust = 0.5, face = "bold"))  # et on centre le titre, en gras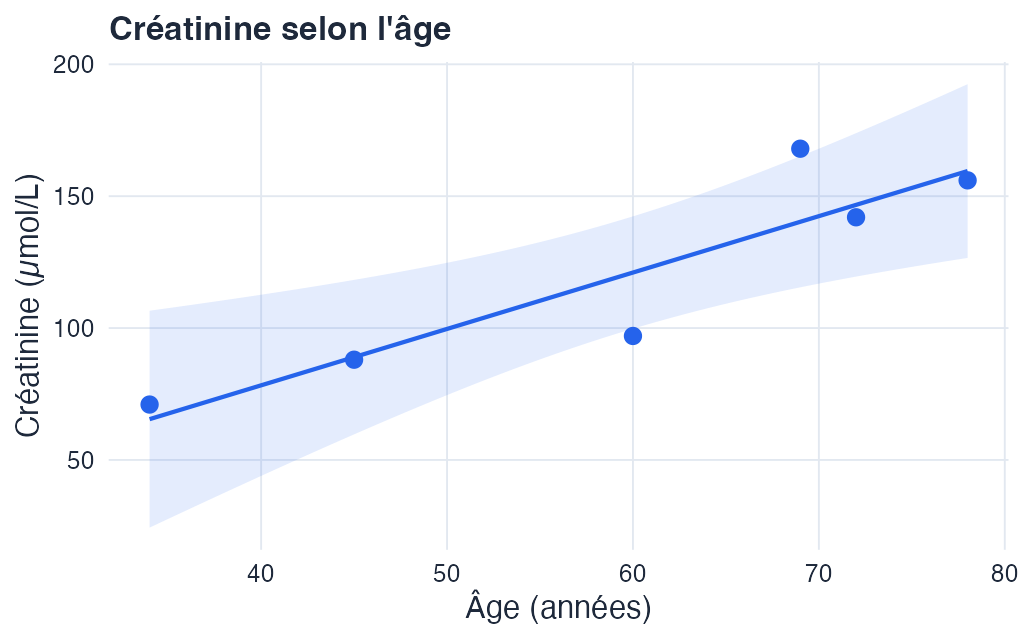
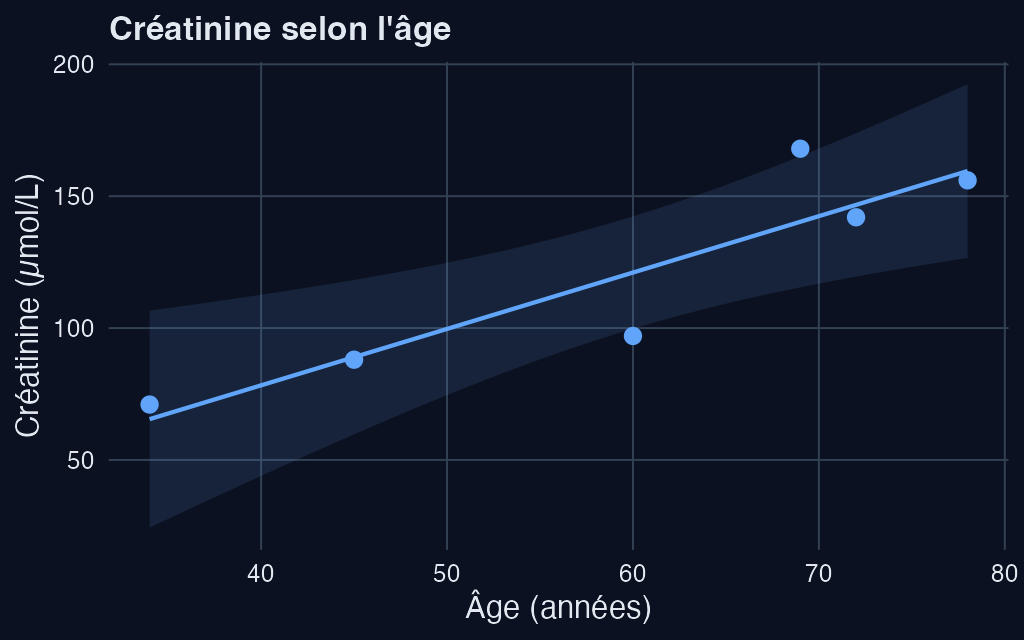
Chaque + ajoute une couche. C’est ce qui rend ggplot2 si simple à prendre en main : en quelques lignes, on obtient déjà une figure propre, avec la droite de régression et son intervalle de confiance calculés automatiquement. On peut ensuite la personnaliser à volonté (couleurs, thèmes, annotations) et l’exporter pour un article ou une présentation. Pour voir tout ce qu’il est possible de faire, parcourez la R Graph Gallery, qui présente des centaines de graphiques avec leur code.
Shiny : des applications web interactives
Avec la librairie Shiny, on crée des applications web interactives entièrement en R. L’utilisateur choisit des paramètres dans des menus, et les tableaux et graphiques se mettent à jour instantanément.
Une application Shiny qui regroupe des fleurs selon leurs mesures (algorithme des k-moyennes) : changer une variable ou le nombre de groupes met le graphique à jour aussitôt. Exemple tiré de la galerie Shiny de Posit.
Quelques dizaines de lignes de code suffisent pour une application comme celle-ci. En santé, Shiny sert par exemple à construire un tableau de bord pour suivre une cohorte, à laisser des cliniciens explorer des résultats sans écrire de code, ou à partager un outil de calcul avec une équipe. Pour vous faire une idée de ce qui est possible, parcourez la galerie Shiny.
Le machine learning avec tidymodels
R permet aussi de faire du machine learning. La collection de librairies tidymodels, conçue dans le même esprit que le tidyverse, offre une syntaxe unique pour entraîner et évaluer des modèles très différents : régression logistique, forêt aléatoire, gradient boosting…
L’exemple ci-dessous utilise le jeu de données Pima, fourni avec R : les mesures cliniques (glycémie, IMC, âge…) de 532 femmes amérindiennes Pima vivant en Arizona, avec pour chacune la présence ou non d’un diabète. On entraîne une forêt aléatoire sur une partie des patientes, puis on mesure sa capacité à prédire le diabète chez les autres.
library(tidymodels)

# On charge le jeu de données Pima, déjà séparé en données d'entraînement et de test
data(Pima.tr, Pima.te, package = "MASS")

set.seed(42)
modele <- rand_forest(mode = "classification") |>  # on choisit une forêt aléatoire
fit(type ~ ., data = Pima.tr)                     # qu'on entraîne à prédire le diabète (type)

predict(modele, Pima.te, type = "prob") |>          # on prédit la probabilité de diabète sur les données de test
bind_cols(Pima.te) |>                             # on y joint les vraies valeurs
roc_auc(truth = type, .pred_Yes, event_level = "second") # et on calcule l'AUC| .metric | .estimator | .estimate |
|---|---|---|
| roc_auc | binary | 0.828 |
L’AUC mesure la capacité du modèle à distinguer les patientes diabétiques des autres : 1 correspond à une prédiction parfaite, 0,5 au hasard.
R ou Python pour le machine learning ?
tidymodels couvre les méthodes classiques, mais l’écosystème de machine learning de R reste plus limité que celui de Python : moins de méthodes disponibles, et l’apprentissage profond (deep learning) se pratique presque exclusivement en Python. Pour un projet de machine learning ambitieux, la librairie scikit-learn, présentée dans l’introduction à Python, est la référence.
R et Linkr
Les analyses statistiques que vous concevez dans le Study Designer — définition de la population, calcul de variables — correspondent à ce que vous feriez en R après extraction. Comprendre R vous permet de prolonger une analyse au-delà de ce qu’un outil graphique propose, et de vérifier vos résultats.
Vous pouvez aussi écrire et exécuter du R directement dans Linkr, grâce à son IDE intégré : l’éditeur de code, la console et les graphiques sont dans la même fenêtre que vos données. Essayez-le dans la démo.
Ressources pour se former
Ce que vous allez apprendre
- Un manuel complet en français, coordonné par Joseph Larmarange : prise en main, manipulation des données, graphiques, statistiques.
- Commencez par la partie Prise en main, puis piochez les chapitres selon vos besoins.
Ce que vous allez apprendre
- De l’installation de R à l’import, la modification et l’export de vos premières données.
- Court et progressif : idéal pour démarrer.
Ce que vous allez apprendre
- Le flux de travail complet : importer, nettoyer, transformer, visualiser, communiquer.
- Écrit par Hadley Wickham (créateur du tidyverse) et Mine Çetinkaya-Rundel, avec des exercices à chaque chapitre.
- La référence pour apprendre le tidyverse en profondeur.
Ce que vous allez apprendre
- Le parcours officiel, de l’installation de R et RStudio aux premiers graphiques.
- Idéal pour démarrer avant d’attaquer R for Data Science.
Ce que vous allez apprendre
- Construire des applications web avec Shiny, de la première interface aux applications complexes.
- Écrit par Hadley Wickham, la référence sur Shiny.
Parcours conseillé pour R
- Installez R et Positron, puis faites vos premiers pas avec, au choix, le cours OpenClassrooms (court, ~6 h) ou le manuel analyse-R (plus complet).
- Approfondissez le tidyverse avec R for Data Science (en anglais), la référence.
- Pour aller plus loin et créer des applications web, enchaînez avec Mastering Shiny.
- R est le langage des statistiques : idéal pour analyser et visualiser des données une fois extraites en SQL.
- On travaille généralement dans Positron ou RStudio, avec le tidyverse — un ensemble de librairies qui couvre l'essentiel de la manipulation de données.
- Les verbes
filter(),select(),group_by(),summarise()reprennent les briques d'une requête SQL ;ggplot2produit une figure propre en quelques lignes. - Shiny permet de créer simplement des applications web interactives, entièrement en R.
- tidymodels permet de faire du machine learning en R, avec un écosystème plus limité qu'en Python.
- Ressources : en français, le cours OpenClassrooms ou le manuel analyse-R ; en anglais, R for Data Science puis Mastering Shiny.
- On peut aussi coder en R directement dans l'IDE de Linkr.