En résumé
Python est un langage généraliste très lisible, devenu un standard de la data science. Comme R, il sert à nettoyer, analyser et visualiser des données une fois extraites en SQL — grâce aux librairies polars (tableaux de données) et seaborn (graphiques). C’est surtout le langage de référence en machine learning, avec la librairie scikit-learn. On l’utilise souvent dans des notebooks Jupyter.
Cet article prolonge Pourquoi apprendre à coder ? et l’introduction à R. Il suit le même plan que l’article sur R, pour comparer facilement les deux langages.
Pourquoi Python
R est un langage spécialisé, conçu pour les statistiques. Python, au contraire, est un langage généraliste, au même titre que C ou Java : il n’a pas été conçu pour une discipline en particulier, mais pour écrire toutes sortes de programmes de façon lisible. C’est aujourd’hui le langage de programmation le plus utilisé au monde : il est en tête de l’index TIOBE, qui mesure la popularité des langages (octobre 2026). Cela lui donne des atouts complémentaires de ceux de R :
- Polyvalence : au-delà de l’analyse de données, Python sert à automatiser des tâches, manipuler des fichiers, interroger des sites web, construire des applications.
- Machine learning : les grandes librairies d’apprentissage automatique et d’intelligence artificielle (scikit-learn, PyTorch…) sont en Python. C’est incontournable dès qu’on s’oriente vers la modélisation prédictive.
- Lisibilité : sa syntaxe épurée en fait un bon premier langage, y compris pour qui n’a jamais programmé.
R ou Python ?
Les deux sont d’excellents choix pour débuter. R est particulièrement adapté à la biostatistique et à la visualisation statistique ; Python est plus polyvalent et incontournable en machine learning. Le plus efficace : commencer par celui qu’utilisent vos encadrants, puis découvrir l’autre quand le besoin se présente.
L’environnement de travail
En data science, on écrit souvent Python dans des notebooks Jupyter : un document qui alterne des cellules de code, leurs résultats (tableaux, graphiques) et du texte explicatif. C’est idéal pour explorer des données pas à pas et partager une analyse commentée. Pour en voir un exemple, ouvrez le notebook 02_ml_mortality.ipynb dans l’IDE de la démo de Linkr : il entraîne un modèle de prédiction de la mortalité en réanimation, cellule par cellule.
Pour écrire vos propres scripts et notebooks, les environnements présentés dans l’introduction à R fonctionnent aussi pour Python : Positron gère R et Python dans la même interface, et VS Code est très utilisé par les développeurs Python.
polars : manipuler les données
polars est une librairie moderne et rapide pour manipuler des données tabulaires en Python. Elle organise les données dans un objet appelé DataFrame — un tableau avec des lignes et des colonnes nommées, comme une feuille de calcul. Sa syntaxe est proche de celle de dplyr en R : on enchaîne des verbes qui reprennent les briques d’une requête SQL — filter() (comme WHERE), select() (comme SELECT), group_by() + agg() (comme GROUP BY).
import polars as pl

# On crée un tableau de patients avec les colonnes sexe, age et creatinine
patients = pl.DataFrame({
  "sexe":       ["F", "M", "F", "F", "M", "F"],
  "age":        [72, 45, 34, 78, 60, 69],
  "creatinine": [142, 88, 71, 156, 97, 168],
})

(
  patients
  .filter((pl.col("sexe") == "F") & (pl.col("age") > 65))  # on filtre les femmes de plus de 65 ans
  .group_by("sexe")                                         # on regroupe par sexe
  .agg(
      n=pl.len(),                                           # on calcule le nombre de patientes
      creat_moy=pl.col("creatinine").mean(),                # et la créatinine moyenne
  )
)| sexe | n | creat_moy |
|---|---|---|
| F | 3 | 155.333333 |
Si vous avez lu les articles SQL et R, vous reconnaissez la même logique : filtrer les lignes, regrouper, résumer. Seule la syntaxe change. En pratique, on charge souvent les données depuis un fichier CSV (un tableau texte où les colonnes sont séparées par des virgules) avec pl.read_csv("patients.csv"), format d’échange très courant.
Comme en R, quelques commandes reviennent au tout début d’une analyse pour comprendre les données :
patients.shape         # on compte les lignes et les colonnes
patients.describe()    # on résume chaque colonne (min, max, moyenne…)
patients.null_count()  # on compte les valeurs manquantes par colonne
Ces trois lignes donnent une première image de la structure et de la qualité des données.
Un équivalent du tidyverse en Python
Python n’a pas de tidyverse à proprement parler, mais des librairies équivalentes existent pour chaque usage. Posit, l’entreprise derrière RStudio et Positron, investit d’ailleurs de plus en plus dans Python : Positron, Shiny ou encore Great Tables fonctionnent désormais avec les deux langages.
| Usage | R | Python |
|---|---|---|
| Manipuler des tableaux | dplyr | polars |
| Créer des graphiques | ggplot2 | seaborn, plotnine |
| Mettre en forme des tableaux de résultats | gt | Great Tables |
| Créer des applications web | Shiny | Shiny for Python |
| Machine learning | tidymodels | scikit-learn |
Visualiser avec seaborn
matplotlib est la librairie de base pour tracer des graphiques en Python : elle permet de contrôler chaque détail d’une figure, mais demande beaucoup de code. seaborn, construite par-dessus, simplifie les graphiques statistiques courants. Le code ci-dessous reproduit la figure de l’introduction à R : un nuage de points avec une droite de régression et son intervalle de confiance.
import seaborn as sns
import matplotlib.pyplot as plt

sns.set_theme(style="whitegrid")                    # on choisit un thème épuré
ax = sns.regplot(data=patients, x="age", y="creatinine",
               color="#2563eb")                   # on trace les points et la droite de régression, avec son intervalle de confiance
ax.set_title("Créatinine selon l'âge", fontweight="bold")  # on ajoute le titre, en gras
ax.set(xlabel="Âge (années)", ylabel="Créatinine (µmol/L)")  # et le nom des axes
sns.despine(left=True, bottom=True)                 # on retire le cadre
plt.show()                                          # et on affiche le graphique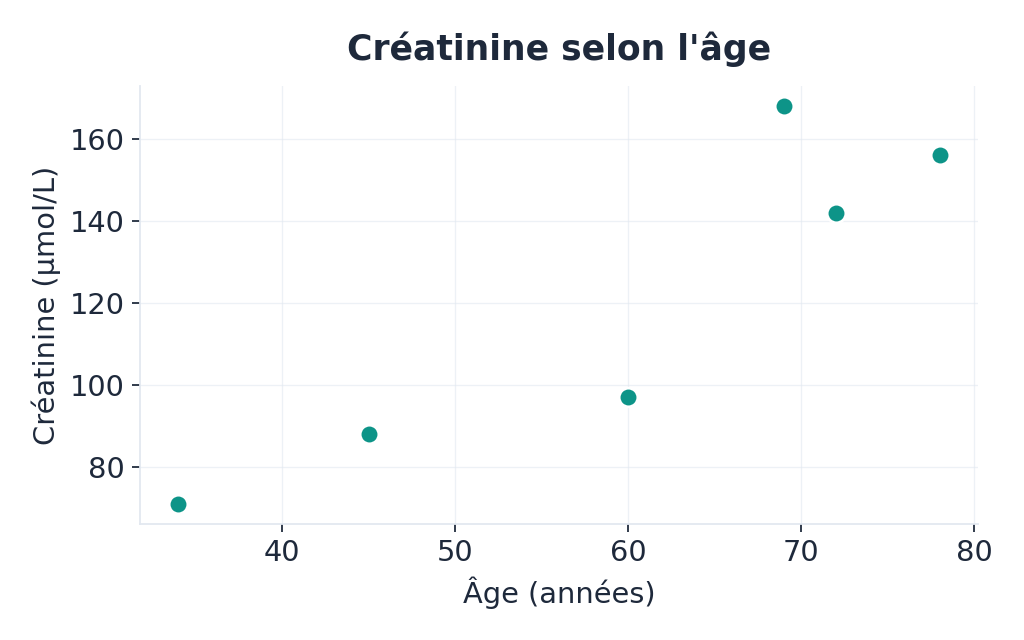
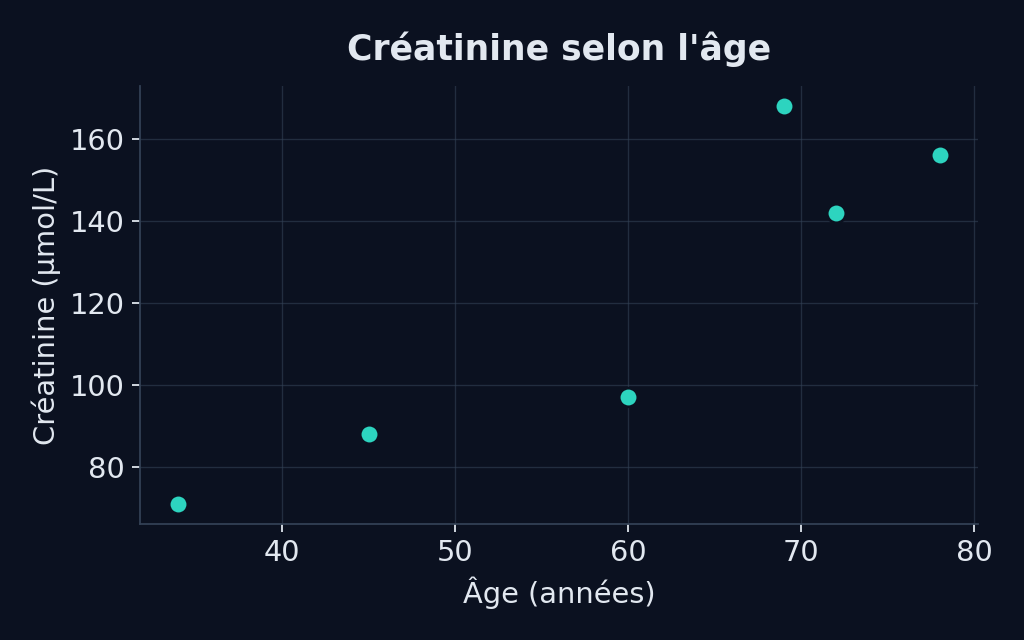
Comme avec ggplot2, quelques lignes suffisent pour obtenir une figure propre. seaborn estime l’intervalle de confiance par rééchantillonnage (bootstrap), d’où son contour légèrement irrégulier. Pour voir ce qu’il est possible de faire, parcourez la Python Graph Gallery, qui présente des centaines de graphiques avec leur code.
Enfin, si vous venez de R, plotnine reprend même la syntaxe de ggplot2 presque à l’identique.
Shiny for Python : des applications web interactives
Comme en R, Shiny permet de créer des applications web interactives en Python : l’utilisateur choisit des paramètres dans des menus, et les tableaux et graphiques se mettent à jour instantanément. Les principes sont les mêmes que ceux présentés dans l’introduction à R. Pour vous faire une idée de ce qui est possible, parcourez la galerie Shiny for Python.
Le machine learning avec scikit-learn
scikit-learn est la librairie de référence pour le machine learning en Python, et probablement la librairie Python la plus importante à connaître pour la recherche en santé. Elle offre une interface unique pour des dizaines de méthodes — régression logistique, forêt aléatoire, gradient boosting, partitionnement… — ainsi que tous les outils pour préparer les données et évaluer les modèles.
L’exemple ci-dessous utilise un jeu de données fourni avec scikit-learn : 569 tumeurs du sein, décrites par 30 mesures issues d’images de prélèvements, chacune classée bénigne ou maligne. On entraîne une forêt aléatoire sur trois quarts des tumeurs, puis on mesure sa capacité à prédire la nature des autres.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import roc_auc_score

# On charge les données : X contient les mesures, y le diagnostic
X, y = load_breast_cancer(return_X_y=True)

# On sépare les données d'entraînement (75 %) et de test (25 %)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)

modele = RandomForestClassifier(random_state=42)  # on choisit une forêt aléatoire
modele.fit(X_train, y_train)                      # qu'on entraîne sur les données d'entraînement

proba = modele.predict_proba(X_test)[:, 1]        # on prédit la probabilité sur les données de test
print(f"AUC : {roc_auc_score(y_test, proba):.3f}") # et on calcule l'AUCAUC : 0.996
On retrouve les mêmes étapes qu’avec tidymodels en R : choisir un modèle, l’entraîner, prédire, évaluer. L’AUC mesure la capacité du modèle à distinguer les deux classes : 1 correspond à une prédiction parfaite, 0,5 au hasard. Ce jeu de données est volontairement facile ; sur des données réelles, les performances sont rarement aussi élevées.
Python et Linkr
Comme expliqué dans l’introduction à R, le code permet de prolonger une analyse au-delà de ce que le Study Designer génère automatiquement : l’outil pour concevoir et cadrer, le code pour explorer sans limite. Python est en particulier le meilleur choix dès qu’on veut entraîner un modèle de prédiction sur des données extraites d’un entrepôt.
Comme pour R, vous pouvez écrire et exécuter du Python directement dans l’IDE de Linkr, y compris dans le navigateur, sans rien installer : essayez-le dans la démo.
Ressources pour se former
Ce que vous allez apprendre
- Les fondations du langage : variables, conditions, boucles, fonctions.
- Parcours francophone accessible aux débutants complets, recommandé par nos étudiants.
- Prévoyez plutôt une dizaine d’heures que les six annoncées si vous partez de zéro.
Ce que vous allez apprendre
- Lire un fichier, filtrer, sélectionner, regrouper et agréger un DataFrame.
- Commencez par Getting started, puis la partie Expressions.
Ce que vous allez apprendre
- Construire des graphiques statistiques : nuages de points, distributions, comparaisons entre groupes.
- De nombreux exemples prêts à adapter à vos propres données.
Parcours conseillé pour Python
- Apprenez le langage avec le cours OpenClassrooms (~10 h), en écrivant le code dans l’IDE de la démo de Linkr : rien à installer.
- Enchaînez sur polars pour manipuler des tableaux, puis seaborn pour visualiser.
- Le machine learning viendra plus tard, dans la section dédiée à l’IA en santé — les cours d’introduction (comme celui d’Andrew Ng sur Coursera) suffisent largement pour commencer.
- Python est un langage généraliste, au même titre que C ou Java, et le plus utilisé au monde : standard de la data science et référence en machine learning.
- polars manipule des tableaux avec la même logique que
dplyret le SQL ; des équivalents existent pour la plupart des librairies du tidyverse. - seaborn produit une figure propre en quelques lignes, comme ggplot2 en R.
- Shiny existe aussi en Python pour créer des applications web interactives.
- scikit-learn est la librairie de référence pour le machine learning.
- On peut coder en Python dans l'IDE de Linkr, y compris dans le navigateur via la démo.